SEO·GEO, 이제 벡터 데이터로 봐야 합니다 | 저희 사이트 116페이지를 직접 바꿔 봤습니다
 글 이준석 Adam · 마켓피디아 대표
목차
검색엔진은 우리 사이트를 어떻게 읽을까요? 키워드 순위표를 아무리 들여다봐도 이 질문에는 답이 안 나옵니다. 지금의 구글 검색과 AI 답변 엔진은 글을 단어 목록이 아니라 뜻을 담은 숫자 묶음으로 바꿔서 비교하기 때문입니다. 이 숫자 묶음을 벡터라고 부릅니다.
저희는 SEO와 GEO도 이제 같은 눈, 곧 벡터로 봐야 한다고 생각합니다. 말로만 하면 설득이 안 되니 저희 사이트부터 해 봤습니다. market-pedia.com의 페이지 116개를 전부 벡터로 바꿔 서로 비교했더니 키워드 표에서는 한 번도 보이지 않던 것이 꽤 드러났습니다.
검색엔진은 글을 무엇으로 읽을까?
예전 검색은 비교적 단순했습니다. 검색어에 들어간 단어가 문서에 얼마나 들어 있는지, 그 문서로 링크가 얼마나 걸려 있는지를 셌습니다. 키워드를 제목과 본문에 넣는 일이 SEO의 기본기였던 것도 그래서입니다.
지금은 여기에 한 단계가 더 붙습니다. 문장을 언어 모델에 넣으면 수백 개의 숫자가 나오고 이 숫자들이 그 문장의 뜻을 나타내는 좌표 역할을 합니다. “구글 유입이 줄었어요”와 “검색 트래픽이 떨어졌을 때”는 겹치는 단어가 거의 없는데도 좌표로 바꾸면 아주 가까이 놓입니다. 뜻이 같으니까요.
AI 답변 엔진도 출처를 고를 때 같은 원리를 씁니다. 질문을 벡터로 바꾼 다음 그 벡터와 가까운 문서 조각을 찾아 답의 재료로 삼습니다. 내 글이 AI 답변에 인용되느냐는 그래서 키워드가 맞느냐보다 뜻의 좌표가 질문 가까이에 있느냐에 더 크게 달려 있습니다. GEO 개념이 처음이라면 GEO 최적화란 글을 먼저 보셔도 좋습니다.
저희 사이트 116페이지를 직접 벡터로 바꿔 봤습니다
방법은 복잡하지 않습니다. 사이트맵에 있는 주소 117개를 모두 불러와서 본문이 너무 짧은 한 페이지를 뺀 116개를 썼습니다. 페이지마다 메뉴와 푸터는 지우고 본문만 남겼습니다. 벡터는 한국어와 영어를 같이 다루는 무료 공개 모델로 만들었고 저희 컴퓨터에서 직접 돌려서 API 비용도 들지 않았습니다.
중간에 손본 데가 하나 있습니다. 이 모델은 한 번에 읽는 길이가 짧아서(128토큰) 긴 글을 통째로 넣으면 앞부분만 읽고 나머지는 버립니다. 그래서 본문을 400자 안팎으로 잘라 조각마다 벡터를 만든 뒤 평균을 냈습니다. 페이지 하나당 평균 11.8조각이었습니다. 제목은 글의 뜻을 가장 압축한 문장이라 두 배로 쳐 줬습니다.
두 페이지가 얼마나 닮았는지는 코사인 유사도1로 쟀습니다. 값이 1에 가까울수록 두 페이지의 뜻이 같은 방향을 가리킵니다. 116페이지끼리 지을 수 있는 짝 6,670쌍을 전부 비교했습니다.
벡터로 보니 무엇이 보였을까?
사이트의 3분의 1이 한 주제에 몰려 있었습니다
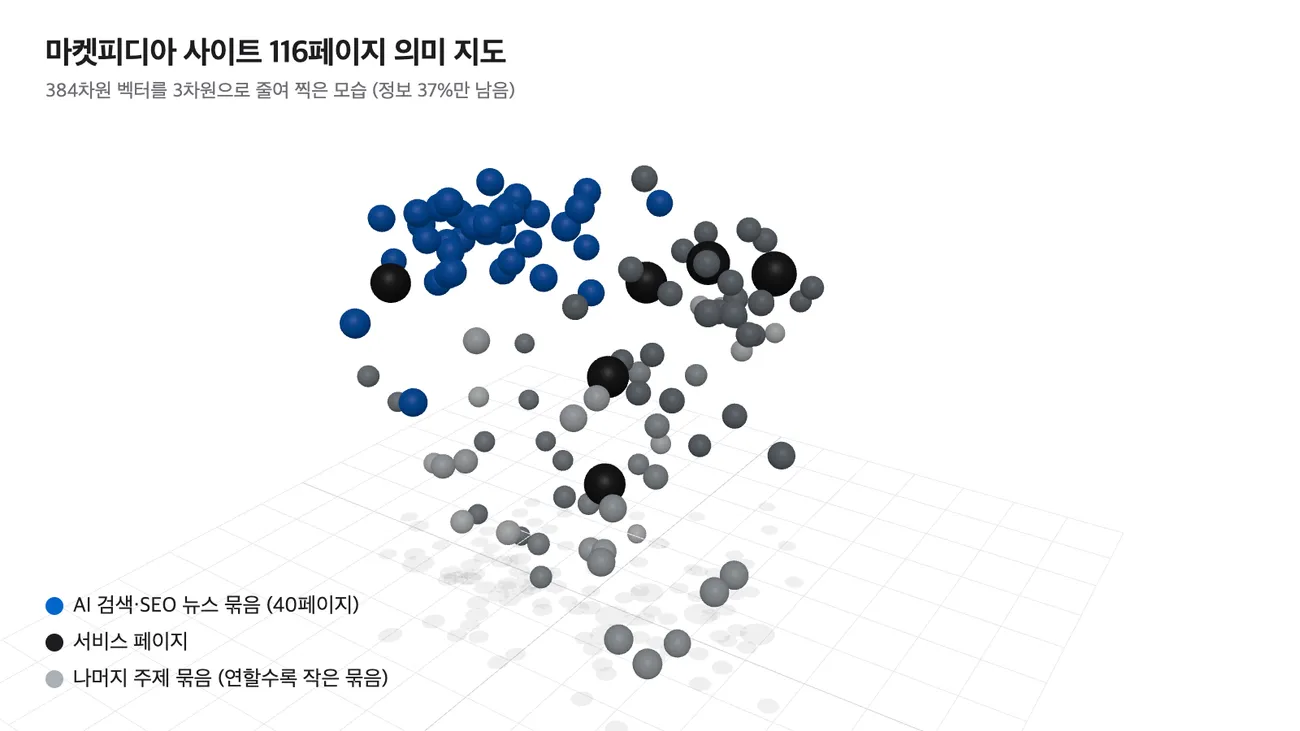
뜻이 가까운 페이지끼리 자동으로 묶어 봤더니 9개 묶음이 나왔습니다. 그중 가장 큰 묶음은 40페이지로 사이트 전체의 3분의 1이었습니다. 이름을 붙이자면 ‘AI 검색과 SEO 뉴스’입니다. 화·목마다 발행하는 SEO 뉴스 글 21편은 한 편도 빠짐없이 이 묶음에 들어 있었습니다.
닮은 정도는 더 눈에 띄었습니다. 6,670쌍 가운데 유사도 상위 1%, 즉 가장 닮은 60쌍을 골라 이어 보면 60쌍 전부가 이 묶음 안에서 생깁니다. 사이트 전체에서 가장 닮은 쌍은 구글 상위노출 2026 글과 7월에 쓴 AI 오버뷰 뉴스 글로, 0.956이었습니다.
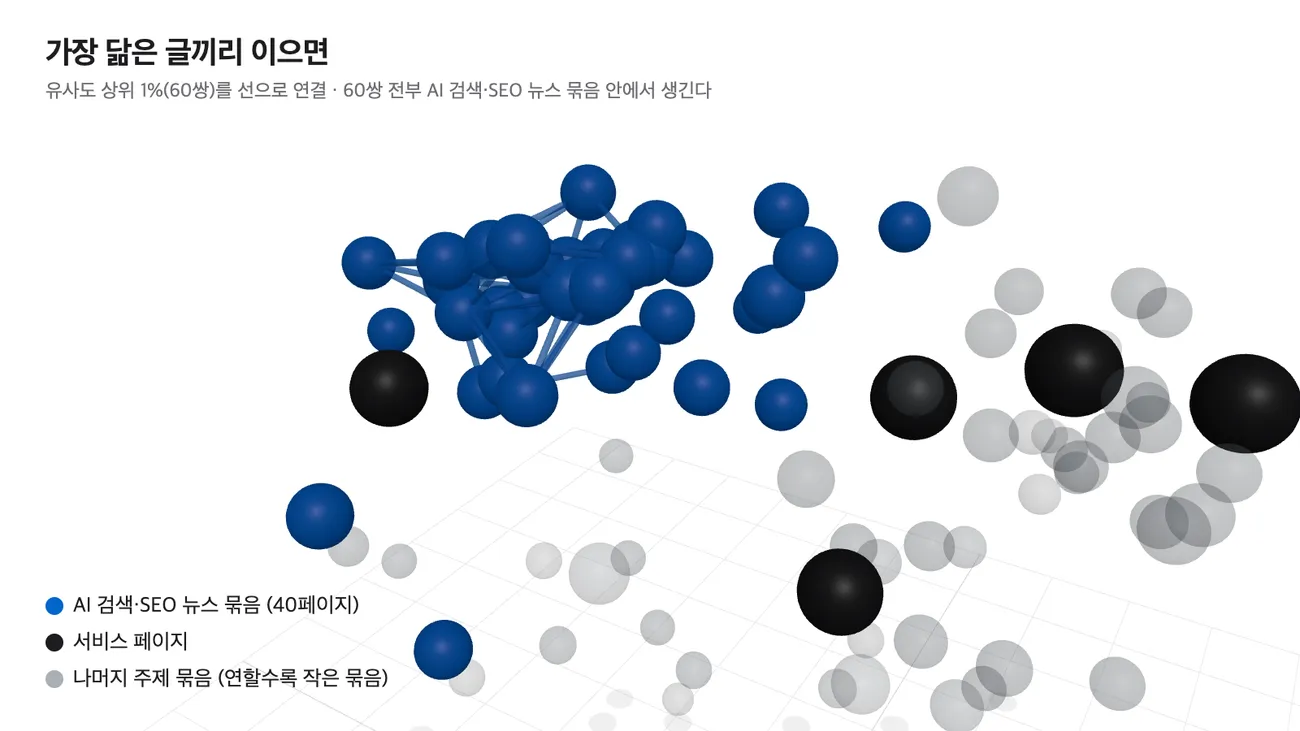
키워드 표로 보면 이 글들은 다 다릅니다. “스팸 업데이트”, “AI 모드 광고”, “서치콘솔 리포트”처럼 겨냥하는 검색어가 매번 달랐으니까요. 그런데 검색엔진이 읽는 방식으로 보면 저희는 비슷한 말을 여러 번 되풀이하고 있었습니다. 뜻이 겹치는 글이 많으면 검색엔진은 그중 무엇을 대표로 보여 줄지 고르기 어려워지고 글끼리 서로의 검색 자리를 빼앗을 수 있습니다. 흔히 콘텐츠 자기잠식이라고 부르는 현상입니다.
GEO 서비스를 받쳐 주는 글이 뉴스 요약이었습니다
이번에는 서비스 페이지 6개마다 가장 가까운 블로그 글을 찾아봤습니다. 서비스 페이지 주변에 뜻이 가까운 글이 많을수록 검색엔진과 AI가 “이 회사는 이 주제를 깊이 다룬다”고 판단할 근거도 늘어난다고 저희는 봅니다.
GEO 서비스 페이지와 가장 가까운 글 1위부터 5위는 모두 SEO 뉴스 요약이었습니다(0.908-0.920). GEO 개념을 처음부터 풀어 쓴 「GEO 최적화란」은 6위(0.902)에 그쳤습니다. AI가 저희의 GEO 전문성을 읽어 갈 때 근거로 삼을 글은 개념과 방법을 담은 글보다 남의 소식을 정리한 글 쪽입니다. 저희로서는 받아들이기 쉽지 않은 결과였습니다.
반대쪽 끝에는 기업 교육 페이지가 있었습니다. 가장 가까운 글마저 0.853으로 서비스 6개 중 가장 낮았습니다. 교육을 실제로 하고 있는데도 사이트 안에는 그 주제를 받쳐 주는 글이 가장 적다는 신호로 읽힙니다.
384차원을 3차원으로 줄이면 무엇이 남고 무엇이 사라질까?
위의 지도는 보기에는 그럴듯하지만 그대로 믿으면 곤란합니다. 페이지 하나는 원래 384개의 숫자, 즉 384차원 공간의 한 점입니다. 사람 눈은 3차원까지밖에 못 보니 384차원을 3차원으로 눌러서 그린 겁니다.
이 누르기는 물체에 빛을 비춰 벽에 그림자를 만드는 일과 비슷합니다. 빛을 잘 비추면 그림자만 보고도 무슨 물건인지 알 수 있습니다. 하지만 그림자에는 두께가 없습니다. 위 지도에 쓴 주성분 분석(PCA)2은 점들이 가장 넓게 퍼지는 방향을 골라 그쪽으로 빛을 비추는 방법입니다. 그렇게 골라 비춰도 얼마나 남는지는 숫자로 나옵니다.
저희 사이트 데이터로 재 보니 3차원 지도에는 원래 정보(퍼진 정도)의 37%만 남았습니다. 2차원으로 줄이면 29%입니다. 80%를 남기려면 21차원, 90%를 남기려면 36차원이 필요했습니다. 384개 중 36개면 꽤 압축한 셈입니다. 그래도 사람이 볼 수 있는 3차원과는 거리가 멉니다.
가까운 이웃이 지도에서도 이웃으로 남는지도 확인했습니다. 원래 384차원에서 페이지마다 가장 닮은 5개를 뽑은 뒤 3차원 지도에서도 가장 가까운 5개 안에 드는지 봤습니다. 남은 비율은 34%였습니다. 점들의 가까운 관계를 살리는 데 더 신경 쓰는 다른 압축법(t-SNE)으로 해도 27%였습니다. 지도에서 두 점이 붙어 있다고 해서 실제로 가장 닮은 사이라고 볼 수는 없습니다.
그럼 3차원 지도는 왜 그릴까요? 저희는 전체 모양을 한눈에 보는 용도로는 충분히 쓸 만하다고 봅니다. 어느 주제에 글이 몰렸는지, 어느 서비스 주변이 비었는지 같은 큰 그림은 지도에서 바로 보입니다. 위에서 본 “3분의 1이 한 묶음” 같은 발견도 지도를 보고 처음 의심하게 됐습니다. 다만 “이 두 글을 합칠까?” 같은 판단은 지도 위치로 하면 안 되고 원래 384차원에서 잰 유사도 숫자로 해야 합니다. 지도로 길을 찾고 결정은 원본 숫자로 내린다고 보시면 됩니다.
SEO·GEO를 벡터로 본다는 건 무엇을 바꿀까?
키워드 표가 보여 주는 건 “어떤 검색어로 몇 위인가”입니다. 벡터로는 “검색엔진과 AI가 우리 사이트를 무슨 뜻의 덩어리로 보고 있나”를 볼 수 있습니다. 저희가 이번에 찾은 것들은 모두 벡터 쪽에서만 보였습니다.
이 결과를 보고 저희는 우선순위를 바꾸기로 했습니다. SEO 뉴스 연재는 글을 더 늘리기보다 주제별 허브 페이지로 묶겠습니다. 가장 닮은 글끼리는 대표 글 하나에 힘을 모으려고 합니다. GEO 서비스 주변은 뉴스 요약 대신 직접 해 본 방법과 데이터를 담은 글로 채울 생각입니다. 이 글이 그 첫 번째입니다. 교육 서비스는 실제로 해 온 교육 내용을 글로 정리해 빈자리를 메울 계획입니다.
새로 쓸 글에도 같은 기준을 씁니다. 쓰기 전에 기존 글과 뜻이 얼마나 겹치는지부터 재 보고 이미 비슷한 글이 있으면 새 글 대신 그 글을 고치는 쪽을 택하려 합니다.
솔직하게 말하면, 한계도 있습니다
자동으로 나눈 묶음은 경계가 또렷하지 않았습니다. 묶음이 얼마나 잘 갈렸는지 보는 실루엣 점수3가 0.281이었습니다. 1에 가까울수록 또렷하고 0이면 경계가 없는 값이니 중간보다 아래입니다. 그래서 묶음 이름은 참고로만 보고 묶음 수가 9개라는 숫자에도 큰 의미를 두지 않았습니다.
유사도 값 자체에도 함정이 있습니다. 조각을 평균 내는 방식을 쓰면 페이지끼리 전반적으로 비슷하게 나옵니다. 저희 사이트에서는 아무 두 페이지나 골라도 중간값이 0.643이었습니다. “0.8이 넘으면 겹친다” 같은 고정 기준 대신 사이트 안에서 상위 1%처럼 상대 순위로 본 것도 이 때문입니다. 모델이나 방법이 바뀌면 숫자도 함께 바뀌니 다른 사이트의 값과 맞대어 비교해서는 안 됩니다.
뜻이 닮았다고 모두 문제인 것도 아닙니다. 매주 같은 분야 소식을 다루는 연재가 서로 닮는 건 자연스럽습니다. 벡터는 “여기를 들여다보라”는 위치까지만 알려 줍니다. 합칠지 그냥 둘지는 검색 성과 데이터를 함께 놓고 사람이 판단해야 합니다. 이번 분석은 무료 다국어 모델 하나로 했습니다. 한국어를 더 잘 다루는 모델로 바꾸면 결과가 일부 달라질 수 있다는 점도 밝혀 둡니다.
우리 사이트도 이렇게 볼 수 있을까?
순서만 보면 어렵지 않습니다. 사이트맵에서 주소를 모아 페이지마다 본문만 뽑은 뒤 벡터로 바꾸고 쌍마다 유사도를 재서 뜻이 가까운 것끼리 묶으면 됩니다. 정작 품이 드는 건 결과를 읽는 쪽입니다. 어느 쏠림이 문제이고 어느 쏠림은 자연스러운지, 서비스 주변에 무엇을 채워야 하는지는 사이트의 사업 구조를 알아야 판단할 수 있습니다. 키워드 중심 점검이 익숙하다면 구글 상위노출 2026 글에서 출발해 이 글로 넘어오셔도 좋습니다.
다음 단계가 필요하다면
우리 사이트도 벡터로 한번 보고 싶으시다면 무료 상담을 남겨 주세요. 상담 전에 사이트를 먼저 살펴본 뒤 어떤 주제에 글이 몰려 있는지부터 정리해서 말씀드립니다.
당장 맡길 단계가 아니라면 SEO·GEO 뉴스레터로 이런 실험 기록을 먼저 받아 보셔도 됩니다. AI 검색에 대비해 무엇을 해야 하는지 전체 그림이 궁금하시면 GEO 최적화 서비스 페이지에 정리해 두었습니다.